Případová studie · Retail & E-commerce

Migrace datového skladu

Kontext

Pro prosperující e-commerce značku specializující se na originální oblečení jsme vybudovali komplexní platformu pro synchronizaci a skladování dat. Systém agreguje roztříštěná data ze Shopify, z různých zdrojů marketingových kampaní a z interních ERP nástrojů do jediné sjednocené reportingové vrstvy. Majitelé e-shopu dnes platformu používají jako primární zdroj pravdy pro marketingová rozhodnutí i pro plánování výroby až na úroveň konkrétních produktových variant a objemů.

SQL ServerAirflowPostgreSQL
Strukturovaná a transparentní orchestrace
Čistá transformační vrstva pod správou verzí
Automatizované zajištění kvality dat jako součást systému
Definice problému a cíl

Původní datový sklad – postavený na SQL Serveru a orchestrovaný nástrojem Apache Airflow – se postupně změnil v neudržitelnou spleť stovek uložených procedur a monolitických pipeline s tisíci vzájemně závislých úloh, bez jakékoli správy verzí. Byznysoví uživatelé přestali datům důvěřovat poté, co naráželi na duplicitní záznamy, protichůdné reporty a nekonzistence, které se odhalovaly až při prezentacích klientům, nikoli díky inženýrskému týmu.

Cíl: nahradit jej platformou, kde jsou data důvěryhodná, dohledatelná a snadno rozšiřitelná.

Odvětví
Retail & E-commerce
Kompetence
Datový skladIntegrace datAutomatizovaná kvalita datOrchestrace pipeline
Technologie
SQL ServerAirflowPostgreSQLDagsterdbt

Výzvy

  1. Křehkost ve velkém měřítku

    Selhání jediné úlohy se mohlo tiše řetězit a na hodiny zablokovat celé pipeline. Chyběla izolace, jasná odpovědnost i možnost rychle zjistit, co se pokazilo a proč.

  2. Neudržitelná transformační logika

    Stovky uložených procedur s překrývající se logikou a nulovou správou verzí dělaly z každé změny hazard.

  3. Narušená důvěra v data

    Duplicitní záznamy, chybějící hodnoty a nesoulad metrik mezi zdroji pravidelně odhalovali zástupci byznysu, nikoli inženýři. Chyběla systematická vrstva zajištění kvality dat – kvalita byla starostí všech, ale odpovědností nikoho.

  4. Vysoká cena každé změny

    Integrace nového zdroje dat znamenala orientaci v nezdokumentované kódové základně bez konzistentních vzorů. Co mělo trvat dny, trvalo týdny, a každé rozšíření vnášelo do existujících pipeline další křehkost.

Řešení

Platformu jsme od základů znovu vybudovali na moderním datovém stacku – Dagster pro orchestraci, dbt nad PostgreSQL pro transformace – s důvěryhodností dat jako hlavní inženýrskou prioritou.

Strukturovaná a transparentní orchestrace

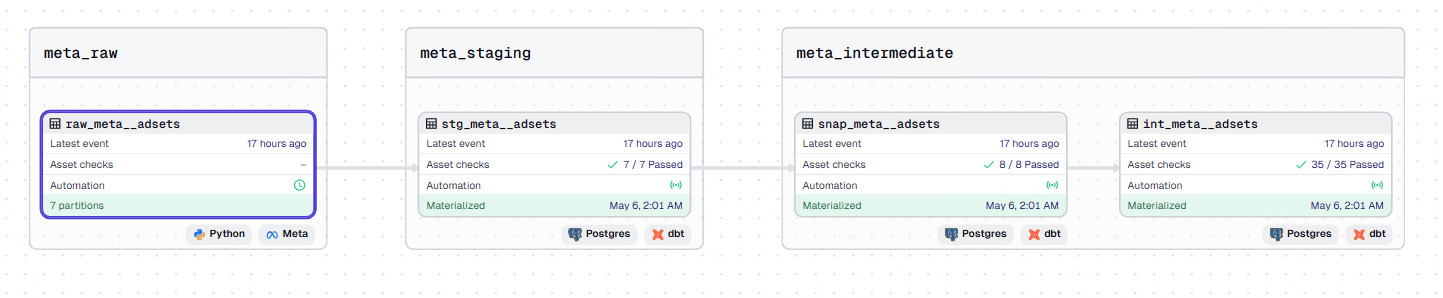
Roli orchestračního enginu převzal místo Airflow Dagster a pipeline jsme přestavěli na malé, jasně vymezené úlohy. Každý zdroj dat sleduje konzistentní, zdokumentovanou strukturu modulů – nové integrace jsou díky tomu předvídatelné a rychlé, bez zásahů do existujícího kódu.
Strukturovaná a transparentní orchestrace

Čistá transformační vrstva pod správou verzí

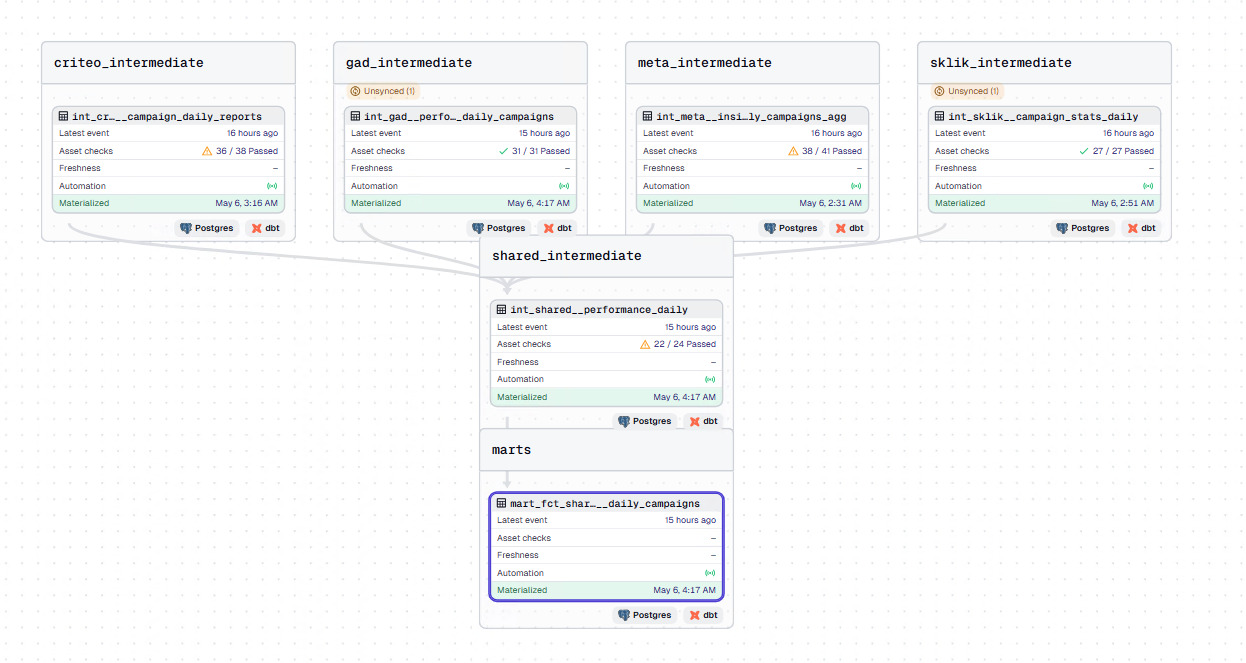
Všechny SQL transformace jsme znovu vytvořili v dbt s využitím striktní třívrstvé architektury: staging, intermediate a marts. Každý model je zdokumentovaný, typovaný a uložený v Gitu – tým má díky tomu úplnou auditní stopu a možnost zkontrolovat každou změnu dřív, než se dostane do produkce.

Čistá transformační vrstva pod správou verzí

Automatizované zajištění kvality dat jako součást systému

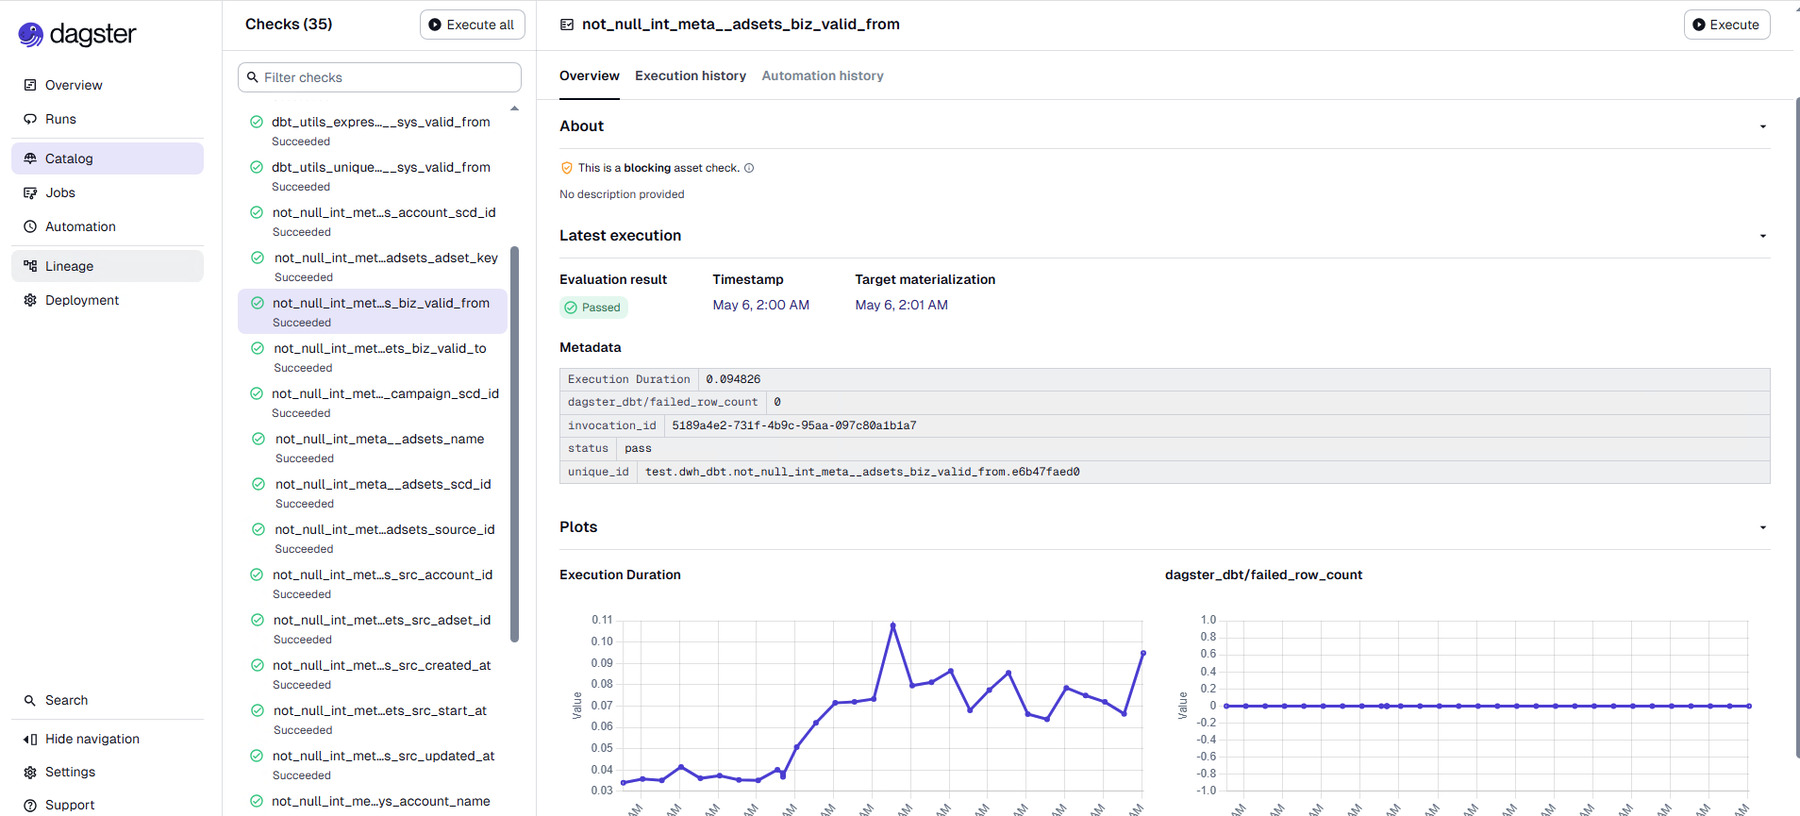
Platforma zahrnuje dvě úrovně automatizovaného testování: strukturální kontroly, jako jsou unikátnost, prázdné hodnoty a referenční integrita, a validaci metrik napříč zdroji – například ověření, že se hodinové útraty kampaní správně sčítají do denních součtů napříč všemi integrovanými reklamními platformami. Spolu s upozorněními a automatickým opakovaným spouštěním úloh kvalitu vynucuje samotný systém, nic není ponecháno náhodě.

Automatizované zajištění kvality dat jako součást systému

Flexibilní příjem dat

Standardizované konektory zpracovávají data z REST API, GraphQL API, souborů CSV i relačních databází v rámci jediného konzistentního frameworku. Přidání nového zdroje dat znamená postupovat podle dobře definovaného vzoru, ne luštit nikde nezapsané know-how.

Základ pro analytiku poháněnou AI

Vrstva marts je navržena se sémantickou srozumitelností – dobře pojmenované entity, konzistentní granularita a čisté definice metrik. Díky tomu je přímo použitelná jako znalostní báze pro nástroje postavené na velkých jazykových modelech: dotazování v přirozeném jazyce, automatizované generování reportů nebo objevování poznatků s pomocí AI se tak stávají realistickými dalšími kroky, ne vzdálenými ambicemi.

Základní funkce

  • Datový sklad
  • Integrace dat
  • Automatizované zajištění kvality dat
  • Orchestrace pipeline
  • Analytické inženýrství
Je to pro vás?

Vaše reporty si odporují. Vaše rozhodnutí by neměla.

Přestavěli jsme datový sklad rychle rostoucí e-commerce značky, jejíž byznysoví uživatelé přestali datům věřit. Stejný problém vzniká všude, kde se na jednom místě potkávají data z e-shopu, marketingu a ERP.

  • E-commerce a retail
  • Marketingová analytika
  • Plánování výroby
  • Firmy řízené daty
Znáte to?

0 z 5 znáte

Jak bychom začali

  1. Zmapovat, co mátePipelines, zdroje a reporty, na které se lidé opravdu spoléhají.
  2. Přestavět v jasných vrstváchMalé, sledovatelné joby a verzované transformace ve vrstvách staging, intermediate a mart, jako s Dagsterem a dbt v tomto projektu.
  3. Testovat data automatickyStrukturální kontroly a validace metrik napříč zdroji, aby se chyby zachytily dřív, než je uvidí byznys.
Přestali jste věřit svým datům?

Řekněte nám
o svém projektu

Popište, co chcete vybudovat. Do 24 hodin se vám ozveme s návrhem dalších kroků.

Potřebujete více informací?

Obraťte se přímo na naše projektové manažery, rádi vám řeknou více.

Romana Kovalová