Fallstudie · Einzelhandel & E-Commerce

Data-Warehouse-Migration

Kontext

Für eine erfolgreiche E-Commerce-Marke, die sich auf originelle Bekleidung spezialisiert hat, haben wir eine umfassende Plattform für Datensynchronisierung und Data Warehousing aufgebaut. Das System führt fragmentierte Daten aus Shopify, unterschiedlichen Marketingkampagnen-Quellen und internen ERP-Tools in einer einzigen, einheitlichen Reporting-Ebene zusammen. Heute nutzen die Betreiber des E-Shops die Plattform als verbindliche Datenquelle für Marketingentscheidungen und für die Produktionsplanung bis hin zu exakten Produktvarianten und Stückzahlen.

SQL ServerAirflowPostgreSQL
Strukturierte, beobachtbare Orchestrierung
Eine saubere, versionierte Transformationsebene
Automatisierte Datenqualität, fest eingebaut
Problemdefinition und Ziel

Das bestehende Data Warehouse – aufgebaut auf SQL Server und orchestriert mit Apache Airflow – war zu einem unwartbaren Geflecht aus Hunderten Stored Procedures, monolithischen Pipelines mit Tausenden voneinander abhängigen Tasks und ohne jede Versionskontrolle gewachsen. Die Fachanwender verloren das Vertrauen in die Daten, nachdem doppelte Datensätze, widersprüchliche Berichte und Inkonsistenzen aufgetaucht waren – entdeckt in Kundenpräsentationen statt vom Engineering-Team.

Das Ziel: eine Plattform, in der Daten vertrauenswürdig, nachvollziehbar und einfach erweiterbar sind.

Branche
Einzelhandel & E-Commerce
Kompetenzen
Data WarehouseDatenintegrationAutomatisierte DatenqualitätPipeline-Orchestrierung
Technologien
SQL ServerAirflowPostgreSQLDagsterdbt

Herausforderungen

  1. Fragilität im großen Maßstab

    Der Ausfall eines einzelnen Tasks konnte sich unbemerkt fortpflanzen und ganze Pipelines für Stunden blockieren. Es gab keine Isolation, keine klaren Verantwortlichkeiten und keine Möglichkeit, schnell zu erkennen, was schiefgelaufen war und warum.

  2. Unwartbare Transformationslogik

    Hunderte Stored Procedures mit überlappender Logik und ohne jede Versionskontrolle machten jede Änderung zum Glücksspiel.

  3. Erodiertes Datenvertrauen

    Doppelte Datensätze, fehlende Werte und Abweichungen zwischen Kennzahlen verschiedener Quellen wurden regelmäßig von den Fachbereichen entdeckt statt von den Entwicklern. Es gab keine systematische Datenqualitätsebene – Qualität war die Sorge aller und die Verantwortung von niemandem.

  4. Hohe Änderungskosten

    Die Integration einer neuen Datenquelle bedeutete, sich durch eine undokumentierte Codebasis ohne konsistente Muster zu arbeiten. Was Tage dauern sollte, dauerte Wochen, und jede Erweiterung brachte neue Fragilität in die bestehenden Pipelines.

Lösungen

Wir haben die Plattform von Grund auf auf einem modernen Data Stack neu aufgebaut – Dagster für die Orchestrierung, dbt auf PostgreSQL für die Transformationen – mit der Vertrauenswürdigkeit der Daten als oberster technischer Priorität.

Strukturierte, beobachtbare Orchestrierung

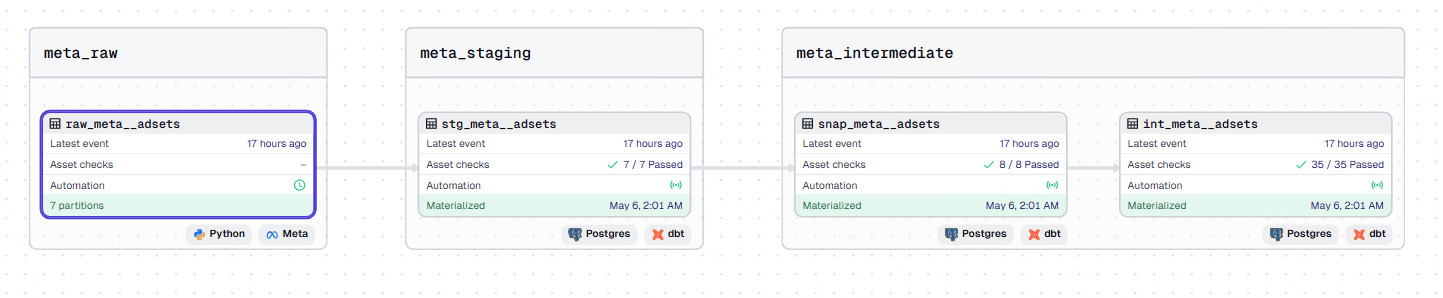
Dagster ersetzte Airflow als Orchestrierungs-Engine; die Pipelines wurden als kleine, klar abgegrenzte Jobs neu aufgebaut. Jede Datenquelle folgt einer konsistenten, dokumentierten Modulstruktur – neue Integrationen werden dadurch vorhersehbar und schnell umsetzbar, ohne bestehenden Code anzufassen.
Strukturierte, beobachtbare Orchestrierung

Eine saubere, versionierte Transformationsebene

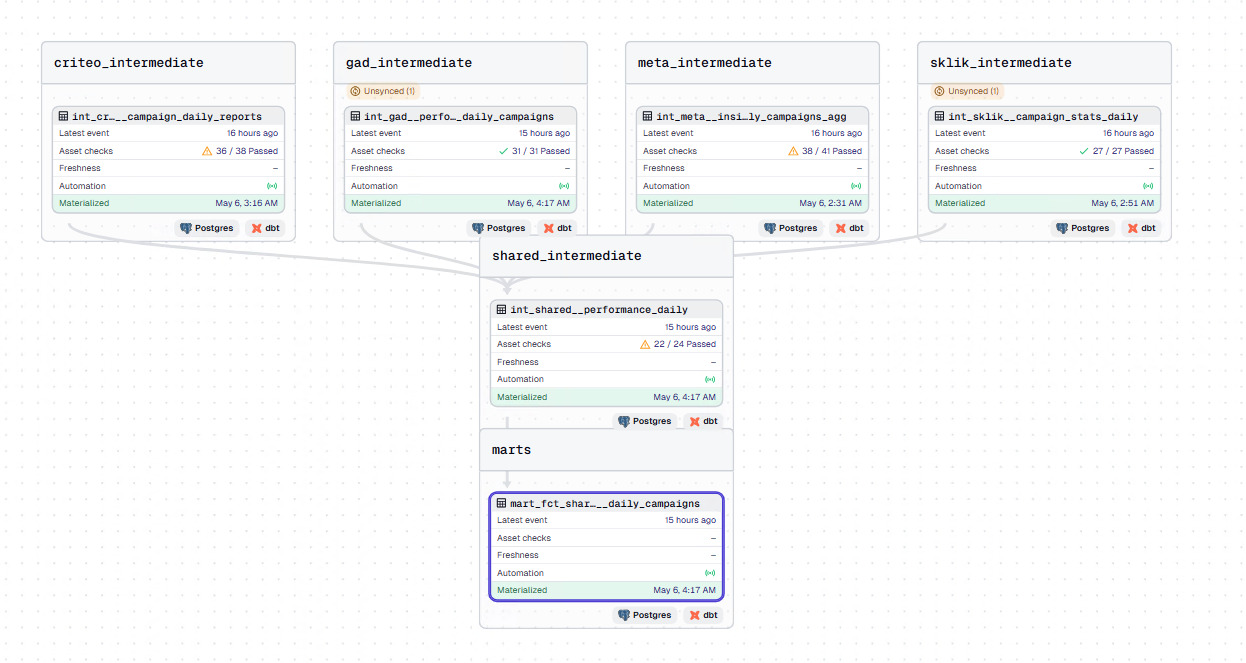
Alle SQL-Transformationen wurden in dbt nach einer strikten Drei-Schichten-Architektur neu aufgebaut: Staging, Intermediate und Marts. Jedes Modell ist dokumentiert, typisiert und in Git versioniert – das Team erhält so einen vollständigen Audit-Trail und kann jede Änderung prüfen, bevor sie die Produktion erreicht.

Eine saubere, versionierte Transformationsebene

Automatisierte Datenqualität, fest eingebaut

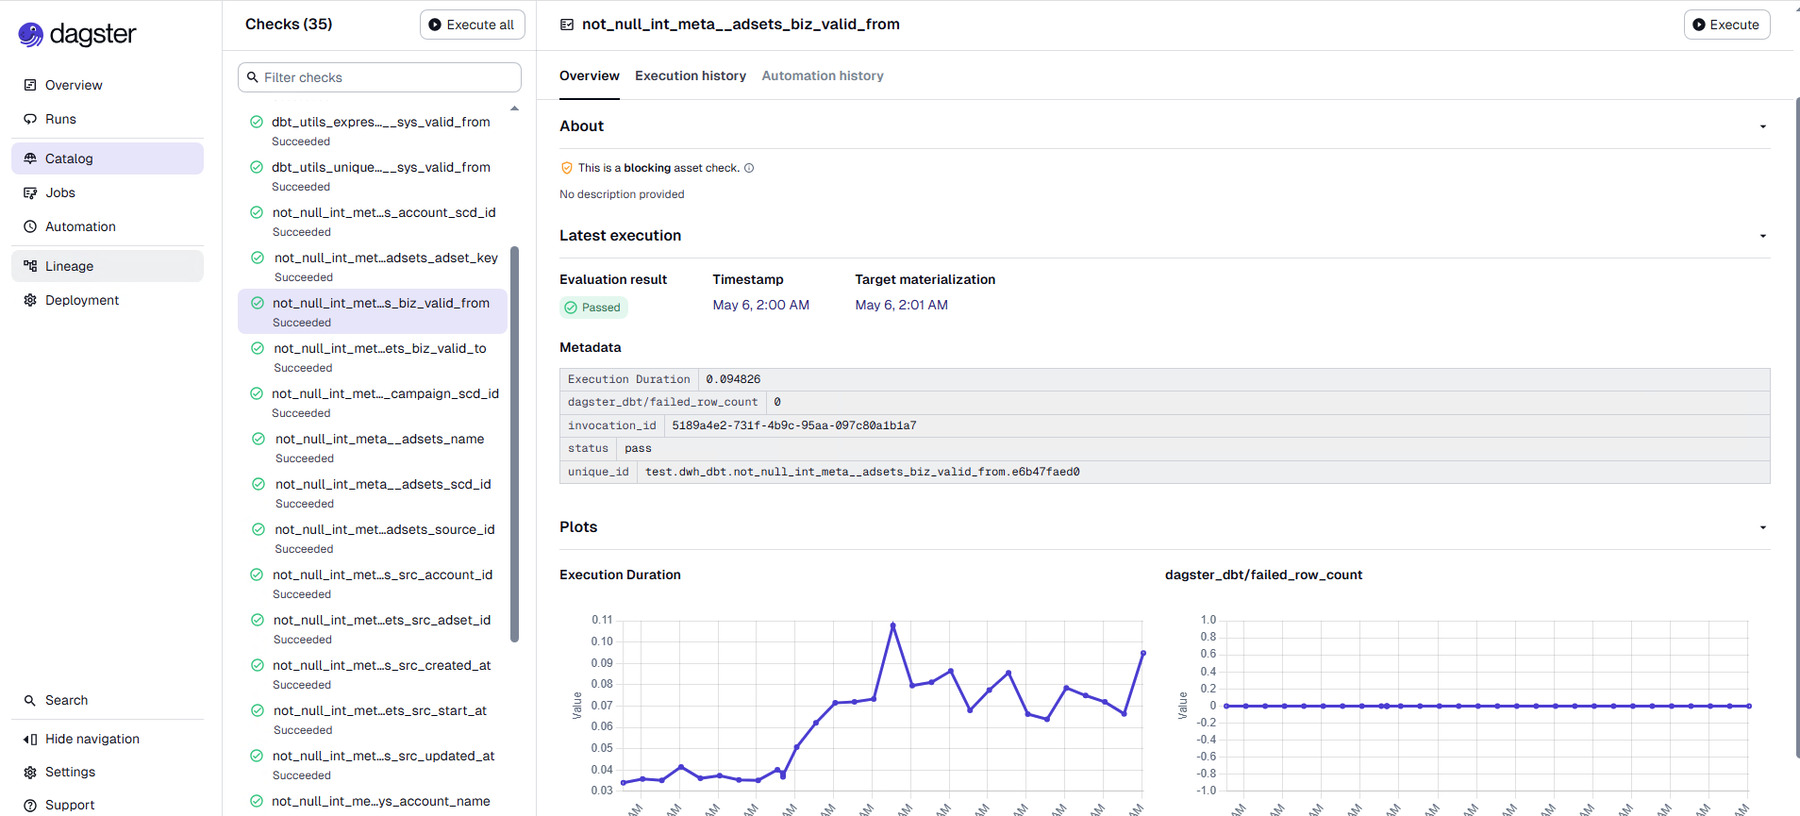
Die Plattform umfasst zwei Ebenen automatisierter Tests: strukturelle Prüfungen wie Eindeutigkeit, Nullwerte und referenzielle Integrität sowie quellenübergreifende Kennzahlenvalidierung – zum Beispiel die Bestätigung, dass sich stündliche Kampagnenausgaben über jede integrierte Werbeplattform hinweg korrekt zu Tagessummen aggregieren. Zusammen mit Alerting und automatischen Wiederholungsläufen wird Qualität vom System erzwungen und nicht dem Zufall überlassen.

Automatisierte Datenqualität, fest eingebaut

Flexible Datenaufnahme

Standardisierte Konnektoren verarbeiten Daten aus REST-APIs, GraphQL-APIs, CSV-Dateien und relationalen Datenbanken in einem einzigen konsistenten Framework. Eine neue Datenquelle anzubinden heißt, einem klar definierten Muster zu folgen – statt undokumentiertes Insiderwissen zu entschlüsseln.

Ein Fundament für AI-gestützte Analytik

Die Mart-Ebene ist auf semantische Klarheit ausgelegt – sprechende Entitätsnamen, konsistente Granularität und saubere Kennzahlendefinitionen. Damit ist sie direkt als Wissensbasis für Large-Language-Model-Tools nutzbar: Abfragen in natürlicher Sprache, automatisierte Berichtserstellung und AI-gestützte Analysen werden zu realistischen nächsten Schritten statt zu fernen Zielen.

Hauptfunktionen

  • Data Warehousing
  • Datenintegration
  • Automatisierte Datenqualität
  • Pipeline-Orchestrierung
  • Analytics Engineering
Passt das zu Ihnen?

Ihre Berichte widersprechen sich. Ihre Entscheidungen sollten es nicht.

Wir haben das Data Warehouse einer schnell wachsenden E-Commerce-Marke neu aufgebaut, deren Fachbereiche den Daten nicht mehr vertrauten. Dasselbe Problem gibt es überall dort, wo Daten aus Shop, Marketing und ERP an einem Ort zusammenkommen.

  • E-Commerce und Handel
  • Marketing-Analytics
  • Produktionsplanung
  • Datengetriebene Unternehmen
Kommt Ihnen das bekannt vor?

0 von 5 kommen Ihnen bekannt vor

So würden wir starten

  1. Bestand prüfenPipelines, Quellen und die Berichte, auf die sich die Leute wirklich verlassen.
  2. In klaren Schichten neu aufbauenKleine, beobachtbare Jobs und versionierte Transformationen in Staging-, Intermediate- und Mart-Schichten, wie mit Dagster und dbt in diesem Projekt.
  3. Daten automatisch testenStrukturprüfungen und quellenübergreifende Kennzahlenvalidierung, damit Fehler auffallen, bevor das Business sie sieht.
Kein Vertrauen mehr in Ihre Daten?

Erzählen Sie uns
von Ihrem Projekt

Beschreiben Sie, was Sie bauen möchten. Wir melden uns innerhalb von 24 Stunden mit einem Vorschlag für die nächsten Schritte.

Noch Fragen?

Wenden Sie sich direkt an unsere Projektmanager, sie erzählen Ihnen gern mehr.

Romana Kovalová