Prípadová štúdia · Retail & E-commerce

Migrácia dátového skladu

Kontext

Pre prosperujúcu e-commerce značku špecializujúcu sa na oblečenie s originálnymi motívmi sme vybudovali komplexnú platformu na synchronizáciu a skladovanie dát. Systém agreguje fragmentované dáta zo Shopify, z rôznych zdrojov marketingových kampaní a z interných ERP nástrojov do jednej zjednotenej reportovacej vrstvy. Majitelia e-shopu dnes platformu používajú ako primárny zdroj pravdy pre marketingové rozhodnutia aj pre plánovanie výroby až na úroveň konkrétnych produktových variantov a objemov.

SQL ServerAirflowPostgreSQL
Štruktúrovaná a pozorovateľná orchestrácia
Čistá transformačná vrstva so správou verzií
Automatizovaná kvalita dát ako súčasť systému
Definícia problému a cieľ

Pôvodný dátový sklad – postavený na SQL Server a orchestrovaný nástrojom Apache Airflow – sa rozrástol do neudržiavateľnej spleti stoviek uložených procedúr, monolitických pipeline s tisíckami vzájomne závislých úloh a bez akejkoľvek správy verzií. Biznis používatelia prestali dátam dôverovať po tom, čo narážali na duplicitné záznamy, protichodné reporty a nezrovnalosti, ktoré sa odhalili až na prezentáciách u klienta namiesto toho, aby ich zachytil inžiniersky tím.

Cieľ: nahradiť ho platformou, v ktorej sú dáta dôveryhodné, sledovateľné a ľahko rozšíriteľné.

Odvetvie
Retail & E-commerce
Kompetencie
Dátový skladIntegrácia údajovAutomatizovaná kvalita dátOrchestrácia pipeline
Technológie
SQL ServerAirflowPostgreSQLDagsterdbt

Výzvy

  1. Krehkosť vo veľkom meradle

    Zlyhanie jedinej úlohy sa mohlo nepozorovane šíriť ďalej a na hodiny zablokovať celé pipeline. Chýbala izolácia, jasné vlastníctvo aj spôsob, ako rýchlo zistiť, čo sa pokazilo a prečo.

  2. Neudržiavateľná transformačná logika

    Stovky uložených procedúr s prekrývajúcou sa logikou a nulovou správou verzií robili z každej zmeny hazard.

  3. Narušená dôvera v dáta

    Duplicitné záznamy, chýbajúce hodnoty a nesúlad metrík medzi zdrojmi pravidelne odhaľovali biznis používatelia namiesto inžinierov. Chýbala systematická vrstva kvality dát – kvalita bola starosťou všetkých a zodpovednosťou nikoho.

  4. Vysoká cena každej zmeny

    Integrácia nového zdroja dát znamenala orientovať sa v nezdokumentovanom kóde bez konzistentných vzorov. Čo malo trvať dni, trvalo týždne a každé rozšírenie vnášalo do existujúcich pipeline novú krehkosť.

Riešenia

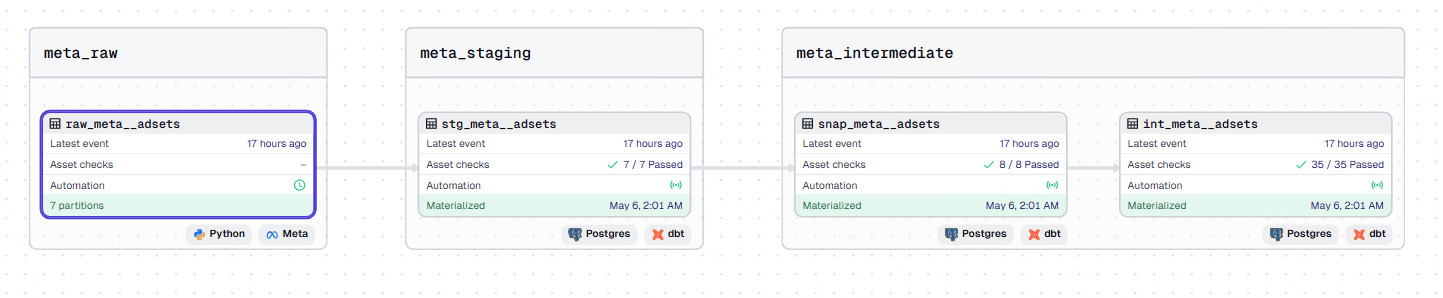
Platformu sme od základov prebudovali na modernom dátovom stacku – Dagster na orchestráciu, dbt nad PostgreSQL na transformácie – s dôveryhodnosťou dát ako hlavnou inžinierskou prioritou.

Štruktúrovaná a pozorovateľná orchestrácia

Dagster nahradil Airflow ako orchestračný engine a pipeline sme prebudovali na malé, jasne ohraničené úlohy. Každý zdroj dát dodržiava konzistentnú, zdokumentovanú štruktúru modulov – vďaka čomu sú nové integrácie predvídateľné a rýchle, bez zásahov do existujúceho kódu.
Štruktúrovaná a pozorovateľná orchestrácia

Čistá transformačná vrstva so správou verzií

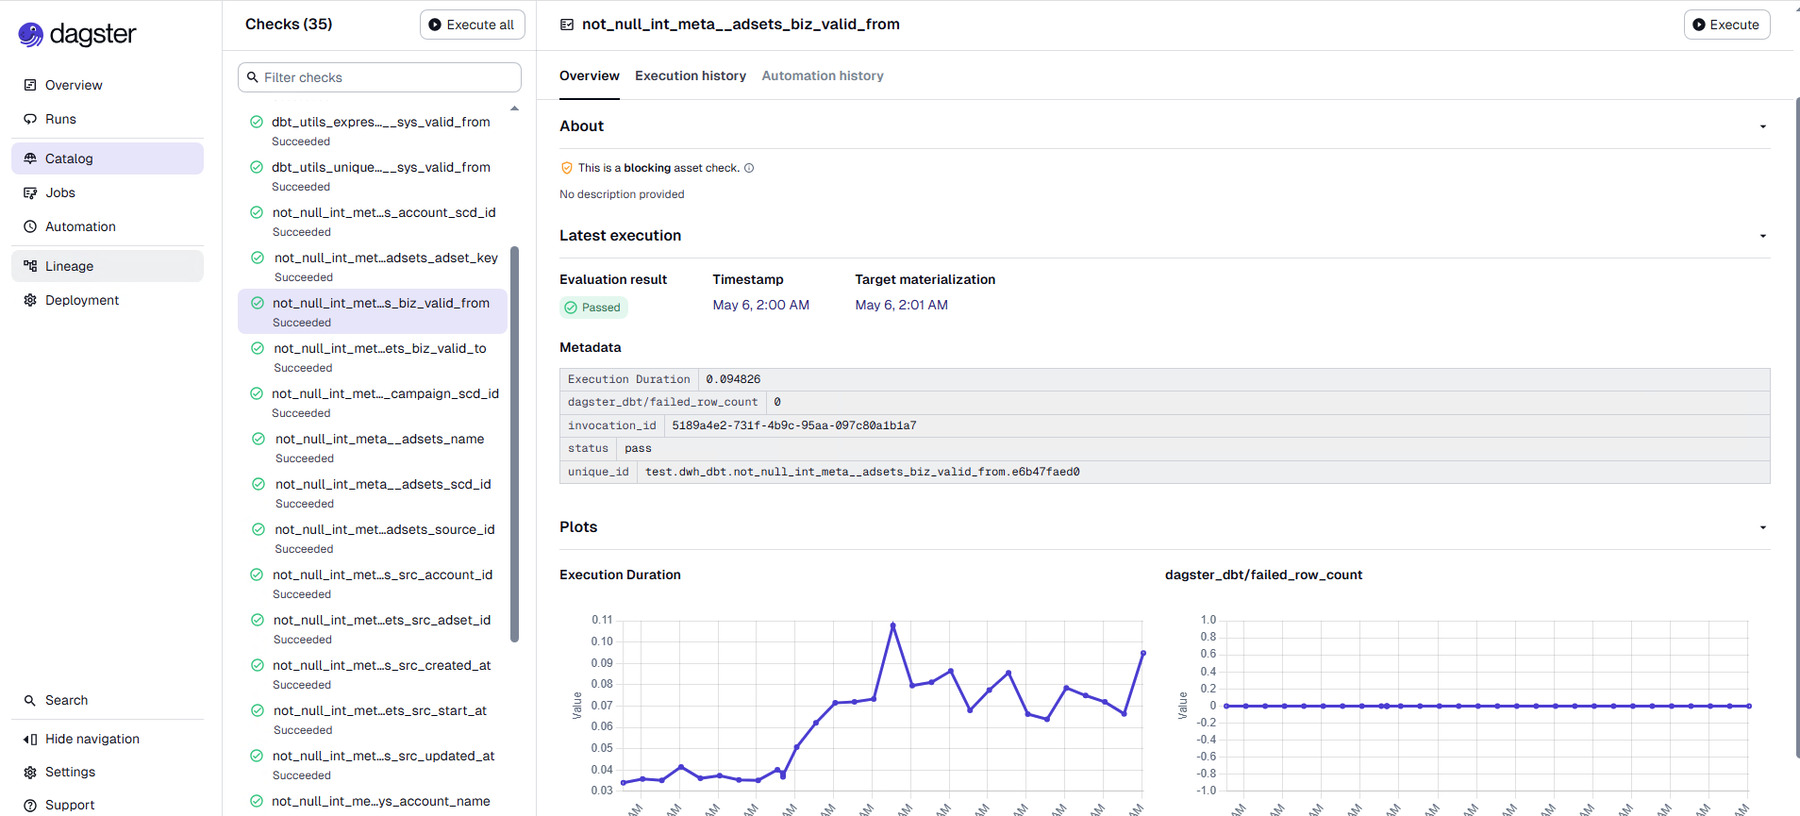
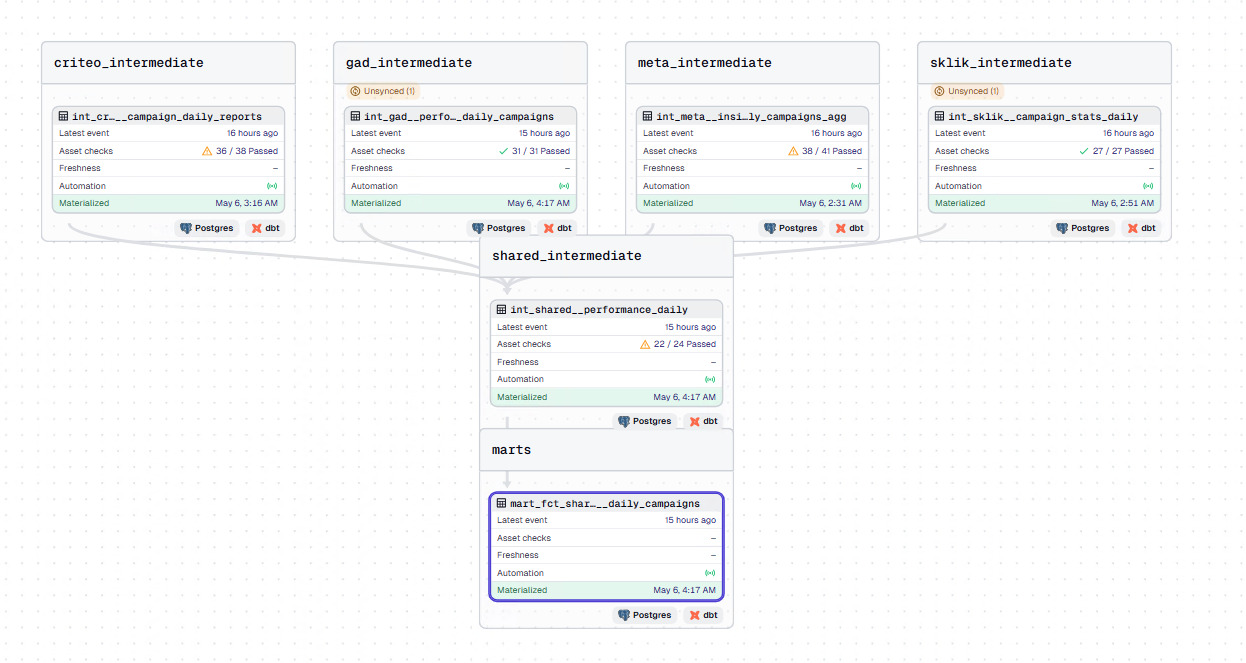
Všetky SQL transformácie sme nanovo vybudovali v dbt s prísnou trojvrstvovou architektúrou: staging, intermediate a marts. Každý model je zdokumentovaný, typovaný a uložený v Gite – tím má tak k dispozícii úplnú históriu zmien a možnosť skontrolovať každú úpravu skôr, než sa dostane do produkcie.

Čistá transformačná vrstva so správou verzií

Automatizovaná kvalita dát ako súčasť systému

Platforma obsahuje dve úrovne automatizovaného testovania: štrukturálne kontroly, ako sú unikátnosť, chýbajúce hodnoty a referenčná integrita, a validáciu metrík naprieč zdrojmi – napríklad overenie, že hodinové výdavky na kampane sa správne agregujú do denných súčtov na každej integrovanej reklamnej platforme. Spolu s upozorneniami a automatickými opakovanými behmi kvalitu vynucuje samotný systém – nie je ponechaná na náhodu.

Automatizovaná kvalita dát ako súčasť systému

Flexibilné načítavanie dát

Štandardizované konektory spracúvajú dáta z REST API, GraphQL API, CSV súborov a relačných databáz v rámci jedného konzistentného frameworku. Pridanie nového zdroja dát znamená nasledovať dobre definovaný vzor, nie lúštiť nezdokumentované know-how.

Základ pre analytiku poháňanú AI

Vrstva marts je navrhnutá so sémantickou čistotou – dobre pomenované entity, konzistentná granularita a čisté definície metrík. Vďaka tomu je priamo použiteľná ako znalostná báza pre nástroje postavené na veľkých jazykových modeloch: dopytovanie v prirodzenom jazyku, automatizované generovanie reportov či objavovanie súvislostí s pomocou AI sa tak stávajú realistickými ďalšími krokmi, nie vzdialenou víziou.

Základné funkcie

  • Dátový sklad
  • Integrácia údajov
  • Automatizovaná kontrola kvality dát
  • Orchestrácia pipeline
  • Analytics engineering
Je to pre vás?

Vaše reporty si odporujú. Vaše rozhodnutia by nemali.

Prestavali sme dátový sklad rýchlo rastúcej e-commerce značky, ktorej biznisoví používatelia prestali dátam veriť. Rovnaký problém vzniká všade, kde sa na jednom mieste stretávajú dáta z e-shopu, marketingu a ERP.

  • E-commerce a retail
  • Marketingová analytika
  • Plánovanie výroby
  • Firmy riadené dátami
Poznáte to?

0 z 5 poznáte

Ako by sme začali

  1. Zmapovať, čo mátePipelines, zdroje a reporty, na ktoré sa ľudia naozaj spoliehajú.
  2. Prestavať v jasných vrstváchMalé, sledovateľné joby a verzované transformácie vo vrstvách staging, intermediate a mart, ako s Dagsterom a dbt v tomto projekte.
  3. Testovať dáta automatickyŠtrukturálne kontroly a validácia metrík naprieč zdrojmi, aby sa chyby zachytili skôr, než ich uvidí biznis.
Prestali ste veriť svojim dátam?

Povedzte nám
o svojom projekte

Opíšte, čo chcete vybudovať. Do 24 hodín sa vám ozveme s návrhom ďalších krokov.

Potrebujete viac informácií?

Obráťte sa priamo na našich projektových manažérov, radi vám povedia viac.

Romana Kovalová